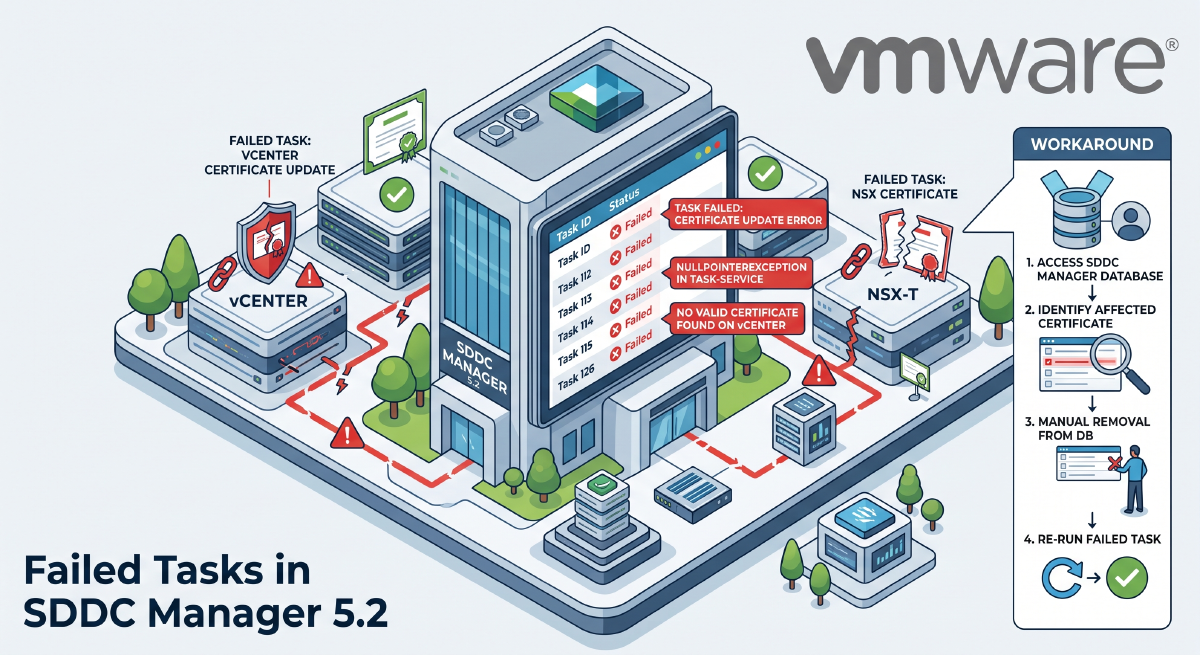
Tarefas com falha no SDDC#
Recentemente enfrentei um caso estranho com a VMware: do nada, começaram a aparecer tarefas com falha no meu SDDC. De início achei que fosse algo relacionado a senha expirada, mas não, dessa vez não.
Os logs não mentem#
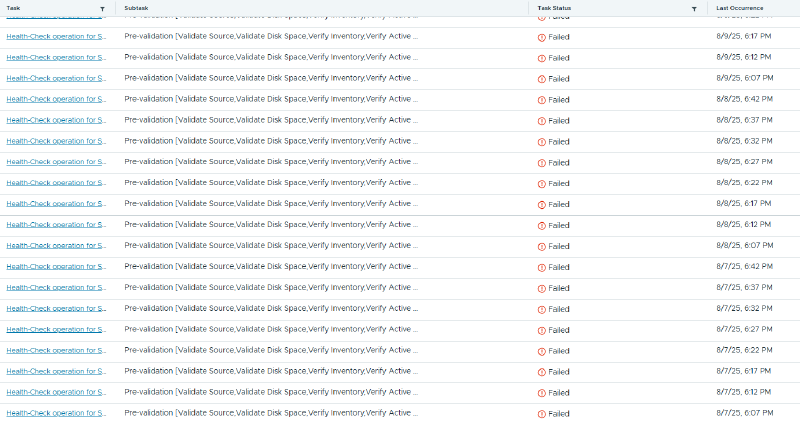
Pessoas mentem, mas os logs não. Depois de alguns dias trabalhando com o suporte da VMware sem encontrar nenhuma pista do que estava acontecendo, vi por acaso algo no healthcheck do SOS que chamou minha atenção: ele reclamava que o SDDC tinha problemas para se conectar ao meu host pela API (porta 443).
Como executar um health check no SDDC
/opt/vmware/sddc-support/sos --health-check --domain-name ALL --skip-cert-check| 21 | ESXi : testhost1.9tec.local | Ping status | GREEN |
| | | API Connectivity status | RED |
| 21 | ESXI : testhost1.9tec.local | svc-vcf-testhost1 | Jul 20, 2025 | Never | Never | GREEN |
| | | root | - | - | - | Failed to get details |
| 21 | ESXi : testhost1.9tec.local | NTP Status | YELLOW |
| | | ESX Time | YELLOW |Poxa, isso me lembrou de uma situação que encontrei não faz muito tempo, em que a minha replicação do vSphere estava fazendo o reverse proxy do ESXi esgotar as sessões (o limite é 128). Referência: ESXi hosts go unresponsive on the vCenter Server with maximum connection exceeded for the envoy proxy.
Bem, vamos olhar o envoy.log deste host em particular e ver o que está acontecendo
less /var/log/envoy.log
## or
less /var/log/envoy.log
Procure pela palavra “exceed” e você verá se há evidências de que o máximo de conexões foi excedido
2025-08-13T22:14:06.853Z In(166) envoy[2100238]: "2025-08-13T22:13:57.261Z warning envoy[2100869] [Originator@6876 sub=filter] [Tags: "ConnectionId":"696461"] remote https connections exceed max allowed: 128"
2025-08-13T22:14:06.853Z In(166) envoy[2100238]: "2025-08-13T22:13:57.261Z warning envoy[2100869] [Originator@6876 sub=filter] [Tags: "ConnectionId":"696461"] closing connection TCP<my_vcenter_IP:59956, my_esxi_IP:443>"
2025-08-13T22:14:06.853Z In(166) envoy[2100238]: "2025-08-13T22:13:57.261Z info envoy[2100869] [Originator@6876 sub=connection] [Tags: "ConnectionId":"696461"] remote address:my_vcenter_IP:59956,TLS_error:|268435588:SSL routines:OPENSSL_internal:CLIENTHELLO_TLSEXT|268435646:SSL routines:OPENSSL_internal:PARSE_TLSEXT"
O workaround#
Como diz a KB mencionada acima, não existe correção, mas há um workaround que consiste em desabilitar o healthcheck da replicação do vSphere (é isso que está consumindo as sessões nos hosts ESXi, por causa das verificações sofisticadas da replicação avançada)
1 - Abra uma sessão SSH no servidor VRMS nos dois sites.
2 - Abra o arquivo /opt/vmware/hms/conf/hms-configuration.xml em um editor de texto
vi /opt/vmware/hms/conf/hms-configuration.xml3 - Defina schedule-health-checks como false
4 - Reinicie o serviço HMS nos dois sites
systemctl restart hms5 - Ao configurar a replicação avançada, pule o health check. Clicar no botão “Next” permite prosseguir com a configuração da replicação sem executar o health check.